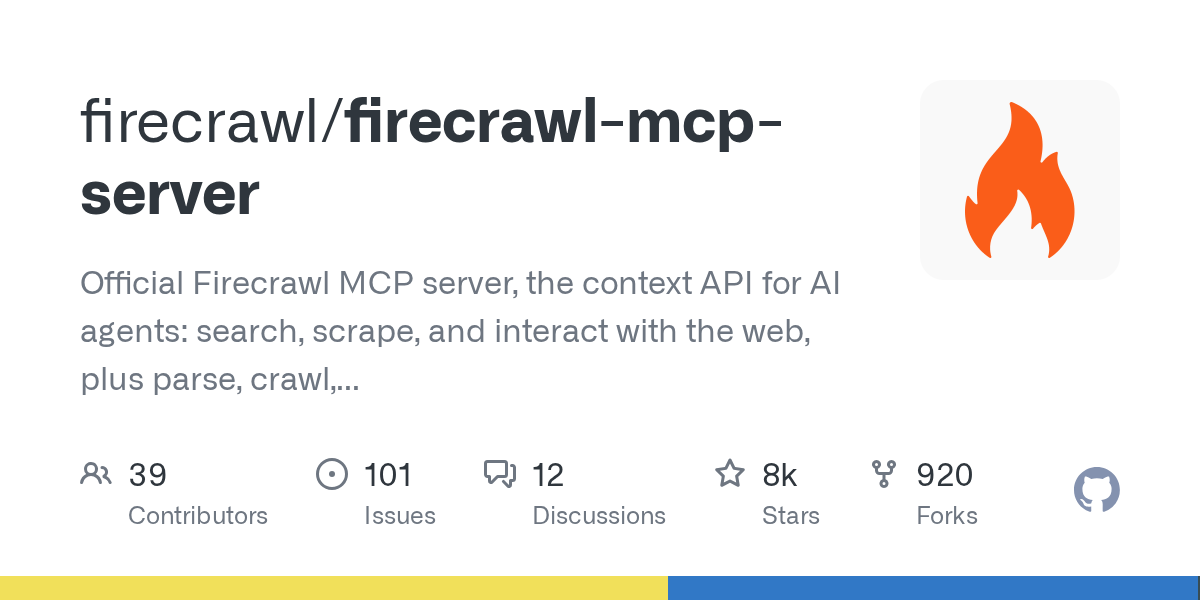
AI Agent 要回答「现在发生了什么」,不能只靠训练数据,它得能联网搜、能抓页面、能读懂动态内容。Firecrawl 一直是「给 AI 用的网页上下文 API」,现在官方把它做成了 MCP 服务:搜索、抓取、解析、爬取、地图、监控、甚至浏览器级交互,全部通过 MCP 协议暴露给任意客户端。和 Apify 偏「Actor 市场」不同,Firecrawl 更像一个统一的「网页上下文引擎」,返回干净 Markdown 或结构化 JSON。
项目基本信息
| 信息项 | 详情 |
|---|---|
| 项目名称 | firecrawl-mcp-server |
| GitHub地址 | https://github.com/firecrawl/firecrawl-mcp-server |
| 项目描述 | Official Firecrawl MCP server, the context API for AI agents: search, scrape, and interact with the web, plus parse, crawl, map, Agent and Monitor, from any MCP client. |
| 作者 | firecrawl |
| 开源协议 | MIT License |
| 开源状态 | 公开 |
| Languages | JavaScript |
| Stars | 7,696 |
| Forks | 919 |
| 支持平台 | Windows / macOS / Linux |
| 最后更新 | 2026-10-27 |
一、项目介绍
Firecrawl MCP Server 是 Firecrawl 官方的 MCP 接入层。它把 Firecrawl 的能力——网页搜索(含开发者源、政府源、论文源索引)、任意 URL 抓取为干净 Markdown/JSON、PDF 解析、整站爬取与 URL 发现、真实浏览器交互、多源研究 Agent、页面变化监控——统一接到 MCP 客户端。支持云托管与自托管,自带重试与限流,对开发者非常友好。
二、核心优势
- 上下文干净:抓取结果直接是可用的 Markdown/JSON,省去清洗。
- 能力强:搜索、爬取、解析、交互、监控一站式。
- 多源索引:覆盖 GitHub issues、论文、政府公开数据等。
- 稳健:自动重试、限流、云/自托管皆可。
三、适用场景
- 给 RAG/问答系统提供实时网页上下文。
- 研究型 Agent 的多源资料聚合。
- 监控竞品或文档页面变化。
- 抓取并结构化任意网页内容。
四、安装教程
推荐使用官方托管端点,客户端配置:
https://mcp.firecrawl.dev/v2/mcp需配置 Authorization: Bearer <你的FIRECRAWL_API_KEY>。本地运行:
npx -y firecrawl-mcp并设 FIRECRAWL_API_KEY。常见报错:401——key 无效或额度耗尽;quota exceeded——升级套餐或自托管。
五、使用示例
接入后让 Agent 调用搜索与抓取:
用 firecrawl_search 搜「TypeScript 5.9 新特性」,再用 firecrawl_scrape
抓取官方公告页,总结要点。
Agent 会返回清洗后的 Markdown,直接用于后续分析或写作。
六、常见问题
- 和 Apify 怎么选?Firecrawl 偏统一上下文引擎,Apify 偏 Actor 生态,按需选用。
- 自托管可行吗?可行,官方提供自托管方案。
- 免费额度?新账号有试用额度。
- 抓动态页?支持真实浏览器交互(点击、填表、导航)。
七、总结
Firecrawl MCP Server 把「联网获取干净上下文」这件事标准化了。它让 AI Agent 不再被训练数据的时间边界困住,是构建实时、联网、可溯源 AI 应用的关键拼图。
评论 0
还没有评论,来说两句吧。